NVIDIA/auto-ontology
- 来源
- GitHub
- 首次上榜日期
- 领域
- RAG 与检索
- GitHub 星标数
- 5,013
- 主要语言
- Python
本页介绍外部开源仓库,并非 HDATF 产品。
它做什么
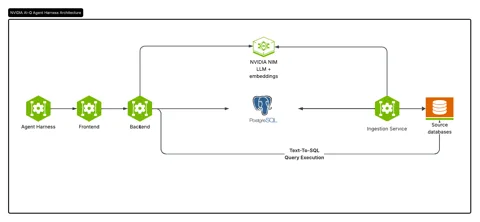
Auto Ontology在企业数据库之上构建共同的语义层,让智能体先确认业务术语的含义,再查询数据。开发者连接源数据库并导入表和列的元数据。业务术语、关系和SQL表达式组成语义目录,保存在Postgres中,并使用向量检索。用户用自然语言提问后,应用生成SQL并在连接的数据源上执行。结果可以包含回答、执行的SQL和查询返回的行。MCP接口通过受限工具集提供术语查询、可回答性检查和问答。部署由Web网关、Python服务、Postgres和配置好的模型端点组成。开始前需要数据库访问权限、认证配置,以及模型调用凭据或对应的端点环境。生成的SQL和回答仍需单独验证,如果没有完整配置Vault,通过界面添加的数据库凭据会以未加密形式存入Postgres。
许可证
Apache-2.0 宽松许可,含专利授权。可商用,需保留声明并注明修改。
同领域的其他仓库
- patchy631/ai-engineering-hub
AI Engineering Hub是面向学习LLM、文档检索和智能体的开发者的教程与示例代码集合。它按难度和主题组织项目,不是一个完整服务,也不是自有模型。示例涵盖文档问答、图片文字提取、聊天界面和MCP连接等组成部分。本次查看的Simple RAG示例读取文件夹内的文档,建立检索索引,再根据相关片段生成回答。其笔记本连接LlamaIndex、通过Ollama运行的llama3.2和HuggingFace嵌入,并基于检索到的两个片段流式输出回答。该示例需要Python 3.10或以上、Ollama、笔记本环境以及另行准备的文档。其他项目使用的模型、外部服务和凭据不同,需要分别检查说明和配置。下载仓库不会自动启用所有功能,本次阅读也不能证明其生产可用性或检索质量。 - StarTrail-org/LEANN
LEANN是一套向量索引和检索工具,面向希望搜索本地文档及记录、又不想为每个文本块完整保存嵌入的用户。它支持检索增强生成,也就是先找到相关原文片段,再让语言模型回答。输入包括PDF、文本和Markdown等文档,或由所提供的数据源示例处理的记录,输出包括匹配片段和可选的模型生成答案。文档示例使用LlamaIndex递归读取文件,将内容切分为文本块后建立索引。其低存储方案保存经过剪枝的图结构,并在检索需要时选择性地重新计算表示语义的数值向量,还可选择HNSW或DiskANN后端。它需要Python环境、嵌入模型或服务端点,生成答案还需要生成模型,原生构建和可选扫描PDF处理会增加操作系统及文字识别依赖。模型既可在本地运行,也可通过云API调用,因此隐私取决于嵌入和答案生成两部分的配置,而不只是索引的位置。重新计算嵌入需要在存储量、计算量和查询延迟之间取舍,提取失败和模型选择也会影响实际可检索内容及结果。README中的存储节省是作者在特定比较条件下报告的结果,不是对所有资料集合或我们数据性能的保证。 - metadist/synaplan-nextcloud
Synaplan Integration是一款连接应用,在Nextcloud文件界面中加入文档摘要、翻译和知识检索对话。主要面向已经用Nextcloud存储文档的组织,以及运营这些环境的托管服务商。它将用户选定的文件或问题发送给已连接的Synaplan服务器,并显示摘要、译文或逐步输出的回答。将文件上传到知识分组后,可用于RAG检索和对话,即先查找相关文档,再将其用于回答。PDF和Office等二进制文档的文本提取由Synaplan的Tika功能处理,而非由这个应用自身完成。开始使用需要受支持的Nextcloud 33至35版本、PHP 8.2及以上版本、运行中的Synaplan实例和有效API密钥。运营方可选择共用账户、创建用户独立账户或连接现有Synaplan账户,独立用户模式的密钥会加密保存在服务器端。个人记忆以及图片和视频生成功能取决于连接服务器的对应服务和模型配置。文件修改后需要通过对话框手动更新,文档和源码都将监视文件夹并自动处理的功能标为尚未实现。 - ARahim3/DigUp
DigUp是一款在macOS 14及以上的Apple Silicon Mac上常驻菜单栏的应用,按内容搜索用户所选文件夹中的文件。目标用户是想用自己的话描述来查找照片、截图、PDF、文档、录音和视频的人,它是采用MIT许可证的免费开源软件。应用在本机运行Google DeepMind的多模态embedding模型(把文本、图像和声音转换为可相互比较的数值向量的模型)EmbeddingGemma 2。它按画面内容读取图像,用Apple文字识别连同文字一起读取截图,PDF包括扫描件在内按页读取,音频按相互重叠的30秒片段读取,视频则每隔几秒取一帧并连同音轨一起读取。搜索结果会在应用支持的范围内打开到对应位置,录音和视频会在QuickTime Player或IINA中从对应时刻开始播放,PDF则在Preview中打开,并把匹配页面中的词填入搜索栏。在内部,llama.cpp在Mac的GPU上运行8位版EmbeddingGemma 2,为每张图片、每一页、每段文字和每段声音生成的768维向量,与FTS5关键词索引一起存入一个SQLite文件。搜索时会把查询向量与所有已存向量比较,并给字词完全一致的结果加分,因此文件名、文档正文和截图中的发票号和错误代码也能按原样找到。可以通过GitHub Releases的DMG或Homebrew安装,无需账号,首次启动时从Hugging Face下载固定版本的模型文件共865MB,并核对大小和SHA-256。据README所述,索引内容只留在Mac内,网络只用于这次下载和可以关闭的每日一次更新检查,应用只读取文件,并跳过密钥文件、证书和.ssh等隐藏文件夹。选好文件夹后,首次索引在几百个文件时需要几分钟,在很大的下载文件夹上约需一小时,从源码构建还会生成digup命令行工具,可以以JSON lines向其他程序返回搜索结果。已公开的发行版是2026年10月的0.6.0和0.6.1,只有macOS DMG,Windows和Linux版本没有公开发行,只存在于代码中。项目评测只涵盖英语、孟加拉语和阿拉伯语,而字词精确匹配无法把中文、日文、泰文这类书写时不用空格的语言切分成词。 - xerj-org/xerj
XERJ是为AI编码智能体等程序索引本地文件夹的Rust搜索引擎,以单个静态可执行文件发布,并且实现了Elasticsearch REST API,因此现有的Elasticsearch客户端和Kibana可以直接连接。README所说的主要用途是reference coding,即智能体克隆与任务相近的开源项目并建立索引,再以带有文件和行号的片段形式检索这些项目解决问题的方法,用来代替grep找到的整个文件。xerj autoindex会把文件夹中的文件无需schema地按类型建成索引,源代码用tree-sitter解析并保留符号和行号,还能处理PDF、XLSX和邮件等文件。搜索支持BM25全文检索、向量kNN和hybrid查询,/_memory API把智能体的记忆按namespace分别存入独立索引,并可按关键词、语义或向量召回。xerj mcp命令是一个提供13个工具的stdio MCP服务器,它把调用转发到另外启动的node上,而xerj init会把XERJ注册到Claude Code和Cursor中。安装方式是安装脚本或适用于Linux、macOS、Windows的可执行文件,默认embedder是离线的feature hashing,启用neural embedder时首次会下载约90 MB的模型文件。快速入门中使用的--insecure选项会同时关闭TLS和API key认证,使任何能访问该端口的人都成为superuser,以其他方式启动时则会用管理员key开启认证。SECURITY_MODEL.md列出了默认关闭TLS、没有字段级和文档级安全及静态数据加密、共享链接会向guest开放整个索引等限制。根据RERANK.md,默认node没有对外连接和telemetry,而把文档内容发送到外部的功能,即通过TypeSafe AI的Jev进行的重排序(rerank)、proxy embedding、WAL tap和S3 backend,只有在运营者开启后才会工作。在README引用的项目自身研究(4种语言的8个任务)中,使用XERJ的智能体输出token为9,982个,少于以grep为主的智能体的26,477个,两者都解决了16次中的16次。README写明这一收益出现在私有代码或训练截止之后的代码上,对于模型已经熟悉的流行库则没有效果甚至有害,而仓库描述中token减少40倍的说法未能在仓库文件中找到依据。调研时的最新版本是2026-10-12发布的release candidate v1.0.0-rc.95,LICENSE文件和GitHub元数据均为Apache-2.0,提交代码贡献需要签署CLA。
只收录进入 Trendshift 排行榜的仓库,榜单仅用于寻找候选项目,不转载名次。说明、许可证和星标数来自各 GitHub 仓库。解读是我们自己的判断。我们尚未测试这些项目,上榜并不证明质量。