NVIDIA/auto-ontology
- 出典
- GitHub
- 初登場日
- 分野
- RAGと検索
- GitHubスター数
- 5,013
- 主な言語
- Python
外部のオープンソース リポジトリを紹介するページです。HDATFの製品ではありません。
何をするか
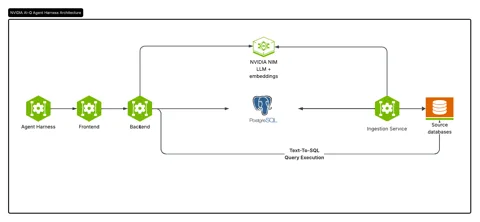
Auto Ontologyは、エージェントが照会前に業務用語の意味を確認できるよう、企業データベースの上に共通の意味体系を構築します。開発者は元のデータベースを接続し、テーブルと列のメタデータを取り込みます。業務用語、関係、SQL式をまとめた意味カタログをPostgresに保存し、ベクトル検索も利用します。利用者が自然言語で質問すると、接続先で実行するSQLを生成して照会します。結果には回答、実行したSQL、取得した行を含められます。MCPでは用語検索、回答可能性の確認、質問処理を限定したツール群で提供します。構成はWebゲートウェイ、Pythonサービス、Postgres、設定済みモデル接続先に分かれます。利用開始にはデータベースへのアクセス権、認証設定、モデル用の認証情報または相当する接続環境が必要です。生成SQLと回答には別途検証が必要で、Vaultを完全に設定しない場合、画面で追加したデータベースの認証情報はPostgresに暗号化されず保存されます。
ライセンス
Apache-2.0 寛容で特許許諾を含みます。商用利用できます。告知を残し、変更点を明記します。
同じ分野のリポジトリ
- patchy631/ai-engineering-hub
AI Engineering Hubは、LLM、文書検索、エージェントを学ぶ開発者向けの教材とサンプルコード集です。一つの完成したサービスや独自モデルではなく、難易度とテーマ別のプロジェクトを集めたリポジトリです。文書への質問応答、画像の文字抽出、チャット画面、MCP接続などの構成要素を例から学べます。確認したSimple RAGの例は、フォルダー内の文書を読み込み、検索用の索引を作り、質問に関連する文章から回答を生成します。ノートブックはLlamaIndex、Ollama経由のllama3.2、HuggingFaceの埋め込みを接続し、検索した二つの文章を基に回答をストリーミングします。この例にはPython 3.10以上、Ollama、ノートブック環境と別途用意する文書が必要です。他のプロジェクトではモデル、外部サービス、認証情報が異なるため、個別の説明と設定を確認する必要があります。取得するだけで全機能が有効になるわけではなく、今回の確認は本番運用への適合性や検索品質を保証するものではありません。 - StarTrail-org/LEANN
LEANNは、すべてのテキスト断片の埋め込みをそのまま保存せずに、ローカルの文書や記録を検索したい利用者向けのベクトル索引と検索のツールです。関連する原文を先に探し、その後で言語モデルに回答させる検索拡張生成に対応します。入力はPDF、テキスト、Markdownなどの文書や、提供される情報源別の例で処理する記録で、出力は関連箇所と任意の生成回答です。文書用の例ではLlamaIndexでファイルを再帰的に読み込み、内容を断片に分けて索引へ渡します。保存量を減らす方式は枝刈りしたグラフを保持し、検索時に必要となる意味の数値表現である埋め込みを選択的に再計算するもので、検索基盤にはHNSWとDiskANNを選べます。Python環境と埋め込みモデルまたは接続先が必要で、回答には生成モデルが加わり、ネイティブビルドや任意のスキャンPDF処理にはOSと文字認識の依存関係もあります。モデルはローカルでもクラウドAPIでも動かせるため、プライバシーは索引の場所だけでなく、埋め込みと回答生成の両方の設定に依存します。埋め込みの再計算は保存量と計算量および検索待ち時間の交換条件であり、抽出の失敗やモデルの選択は実際の検索対象と結果に影響します。READMEの保存量削減は特定の比較条件で著者が報告した結果であり、あらゆる資料や当社データでの性能を保証するものではありません。 - metadist/synaplan-nextcloud
Synaplan Integrationは、Nextcloudのファイル画面に文書要約、翻訳、知識検索チャットを追加する接続アプリです。すでにNextcloudに文書を保管する組織と、その環境を運用するホスティング事業者が主な対象です。利用者が選んだファイルや質問を接続先のSynaplanサーバーへ送り、要約、翻訳、逐次表示される回答を示します。ファイルを知識グループに登録すると、関連文書を検索して回答に使うRAG方式の検索と対話に利用できます。PDFやOfficeなどのバイナリ文書の文字抽出は、このアプリ自体ではなくSynaplanのTika機能が処理します。利用開始にはNextcloud 33から35の対応版、PHP 8.2以上、稼働中のSynaplanと有効なAPIキーが必要です。運用者はアカウント共有、利用者別アカウントの作成、既存Synaplanアカウントの接続を選べ、利用者別方式のキーはサーバー上に暗号化して保存します。個人メモリーや画像と動画の生成は、接続先サーバーの対応サービスとモデル設定に依存します。変更したファイルはダイアログから手動更新する必要があり、フォルダー監視による自動処理は文書とソースで未実装として区別されています。 - ARahim3/DigUp
DigUpは、macOS 14以上のApple Silicon Macでメニューバーに常駐するアプリで、ユーザーが選んだフォルダーのファイルを中身で探します。写真、スクリーンショット、PDF、文書、録音、動画を自分の言葉で説明して探したい人が対象で、MITライセンスの無料のオープンソースです。アプリは、Google DeepMindのマルチモーダルembeddingモデル(テキスト、画像、音を互いに比べられる数値ベクトルに変えるモデル)であるEmbeddingGemma 2を端末内で実行します。画像は写っている内容で、スクリーンショットはAppleの文字認識で文字まで、PDFはスキャンを含めてページ単位で読み、音声は重なり合う30秒の区間で、動画は数秒ごとの1コマと音声を合わせて読みます。検索結果はアプリが対応する範囲で該当する位置で開き、録音と動画はQuickTime PlayerかIINAで該当する瞬間から再生され、PDFは該当ページの語がPreviewの検索欄に入った状態で開きます。内部ではllama.cppが8ビット版のEmbeddingGemma 2をMacのGPU上で実行し、写真、ページ、段落、音の区間ごとに作った768次元のベクトルは、FTS5のキーワード索引と一緒に1つのSQLiteファイルに保存されます。検索では質問のベクトルを保存されたすべてのベクトルと比べ、語がそのまま一致する結果に加点するため、ファイル名、文書本文、スクリーンショットにある請求書番号やエラーコードも書かれたとおりに見つかります。インストールはGitHub ReleasesのDMGかHomebrewで行い、アカウントは不要で、初回起動時に固定されたリビジョンのモデルファイル865MBをHugging Faceからダウンロードし、サイズとSHA-256を確認します。READMEによると、索引にした内容はMacの中だけに残り、ネットワークはこのダウンロードと、オフにできる1日1回の更新確認だけに使われ、アプリはファイルを読むだけで、鍵ファイル、証明書、.sshなどの隠しフォルダーは飛ばします。フォルダーを選んだ後の最初の索引作成は数百ファイルで数分、大きなダウンロードフォルダーで1時間ほどかかり、ソースからビルドすると、ほかのプログラムにJSON linesで検索結果を返せるdigupコマンドラインツールも一緒に作られます。公開された配布版は2026年10月の0.6.0と0.6.1でmacOSのDMGだけであり、WindowsとLinuxのビルドは公開配布なしでコードの中にだけあります。プロジェクトの評価は英語、ベンガル語、アラビア語だけを扱い、語の完全一致検索は中国語、日本語、タイ語のように分かち書きをしない言語を語に分けられません。 - xerj-org/xerj
XERJはAIコーディングエージェントなどのためにローカルフォルダーをインデックス化するRust製の検索エンジンで、1つの静的実行ファイルとして配布され、Elasticsearch REST APIを実装しているため既存のElasticsearchクライアントとKibanaが接続できます。READMEが示す主な用途はreference codingで、エージェントが作業に近いオープンソースのプロジェクトを取得してインデックス化し、grepで見つけたファイル全体の代わりに、その解き方をファイルと行の位置付きの部分として取り出します。xerj autoindexはフォルダー内のファイルをschemaなしで形式別のインデックスにし、ソースコードはtree-sitterで解析してシンボルと行番号を残し、PDF、XLSX、メールなどのファイルも扱います。検索はBM25のfull-text検索、ベクトルのkNN、hybridクエリに対応し、/_memory APIはエージェントの記憶をnamespaceごとに別のインデックスに保存し、キーワード、意味、ベクトルで呼び出します。xerj mcpコマンドは13個のツールを備えたstdioのMCPサーバーで、別に起動しておいたnodeへ呼び出しを転送し、xerj initはXERJをClaude CodeとCursorに登録します。インストールはインストールスクリプトか、Linux、macOS、Windows向けの実行ファイルで行い、既定のembedderはオフラインのfeature hashingで、neural embedderを有効にすると初回に約90 MBのモデルファイルをダウンロードします。クイックスタートで使う--insecureオプションはTLSとAPI keyの認証をどちらも切るため、ポートに届く人は誰でもsuperuserになり、それ以外の方法で起動すると管理者keyで認証が有効になります。SECURITY_MODEL.mdは、既定でオフのTLS、フィールド単位と文書単位のセキュリティと保存データの暗号化がない点、インデックス全体をguestに開く共有リンクを制限として挙げています。RERANK.mdによると、既定のnodeには外部接続とtelemetryがなく、文書の内容を外へ送るTypeSafe AIのJevによる再順位付け(rerank)、proxy embedding、WAL tap、S3のbackendは運用者が有効にした場合にだけ動きます。READMEが引用するプロジェクト自身の研究(4言語の8つの作業)では、XERJを使ったエージェントの出力トークンは9,982で、grep中心のエージェントの26,477より少なく、解決数はどちらも16回中16回でした。READMEはこの利点が非公開のコードや学習時点より後のコードで現れ、モデルが知っている有名なライブラリでは効果がないか不利になりうると書いており、リポジトリの説明にあるトークン40分の1という数値はリポジトリ内のファイルで根拠を見つけられませんでした。調査時点の最新リリースは2026-10-12のrelease candidate v1.0.0-rc.95で、LICENSEファイルとGitHubのメタデータはどちらもApache-2.0であり、コードの貢献にはCLAへの署名が必要です。
Trendshiftのランキングに入ったリポジトリだけを載せ、リストは候補を探すためだけに使いました。順位の数字は転載していません。説明、ライセンス、スター数は各GitHubリポジトリで確認しました。解説は私たちの判断です。これらを試験したわけではなく、上昇リストに載ったことは品質の証明ではありません。