Fractal-Compute-Orchestrations/FractalWorkspace
- 出典
- GitHub
- 初登場日
- 分野
- モデル推論
- GitHubスター数
- 3,574
- 主な言語
- Python
外部のオープンソース リポジトリを紹介するページです。HDATFの製品ではありません。
何をするか
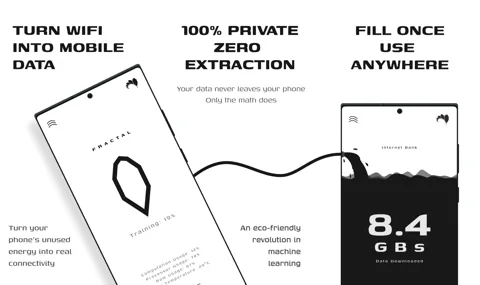
FractalWorkspaceは、PythonサーバーとAndroid端末の計算クライアントをまとめる親ワークスペースと構成資料集です。READMEは、学習タスクを分配して返却チェックポイントを集約する流れと、モデル層を複数端末へ分ける推論を説明しています。入力はモデル、データ断片、端末登録、資源予算で、結果として集約モデル更新や推論出力を示しています。確認したサブモジュール設定はFractalCoreとFractalAndroidを分離しており、親リポジトリだけで計算サービスが稼働するわけではありません。文書上はPython、Androidビルドツール、対応端末、Firestoreを有効にしたFirebaseプロジェクト、サーバーとクライアントの設定が必要です。電池と温度の制限、タスクID、顧客別隔離はシステム契約として説明されていますが、今回の調査では構成部品コードの一貫した実装を検証していません。プライバシー説明はモデルとデータ片のダウンロードを示す図より広いため、元データが絶対に移動しないと仮定せず実際の経路を確認する必要があります。ライセンスは商用制限付きソース公開で、別途許可のない企業内部利用も制限しており、自由に導入できるオープンソース基盤ではありません。
ライセンス
独自ライセンス 標準ではない独自ライセンスです。再利用の前にライセンスファイルを確認してください。
同じ分野のリポジトリ
- deepseek-ai/DeepInfer
DeepInferはDeepSeekモデルの大規模推論用フレームワークで、公開版は完成したオンラインサービスではなくオフライン推論を提供します。モデル運用者がプロンプトとチェックポイントを入力すると、生成トークンとテキストを得られます。明記された対応モデルはDeepSeek-V4.1-Flashで、例にはテキストと画像の入力があります。最適化カーネル、データ並列とエキスパート並列、ドラフトトークンの検証、非同期スケジューリングで処理を構成します。正規表現、JSONスキーマ、文法による出力制約も提供します。Linux、Python 3.12、GCC 13以上とNVIDIA SM100またはHuawei Ascend 950が必要で、それぞれCUDA 13またはCANN 9.2を使います。開始用の例はHugging Faceから重みを取得するか、ローカルのチェックポイントを使います。完全なサービスにはKVキャッシュ機構、処理段階の分離、複製間の負荷分散が別途必要で、公開ベンチマークを一般PCの結果とみなすことはできません。 - deepseek-ai/deepseek-recipe
deepseek-recipeは複数のAI API形式とDeepSeek推論基盤をつなぐRustライブラリーとPythonバインディング集です。Messages、Chat Completions、Responsesの要求を共通会話形式に変え、モデル用プロンプトとトークン入力に変換します。基盤の出力を各プロトコルの完成応答やストリーミングイベントへ戻す処理もあります。ツール定義、生成設定、構造化出力情報を扱いますが、実推論、ツール実行、HTTP転送は呼び出し側が提供します。Python 3.10以上に対応し、画像処理ではOpenCV設定とモデル別対応を確認する必要があります。DeepSeek V4は画像非対応で、V4.1の画像入力経路とは異なります。FastAPIの例は実モデルではなく固定回答の模擬推論を使います。例には認証とプライベートネットワーク宛て画像取得の遮断がないため、導入だけで公開運用サービスにはならず、出力制約の実際の強制も基盤側の責任です。 - omnimind-ai/OmniInfer
OmniInferは、LLMとVLM(画像も読み取る言語モデル)をローカルで実行するRust製のCLI兼ローカルゲートウェイです。実際の推論はllama.cpp、MLX、MNN、vLLMなど既存のランタイムが処理します。リリース版はLinux、macOS、Windows向けで、AndroidとiOSのアプリにはGradleモジュールやSwiftパッケージとして組み込めます。omniinferを実行するとターミナルUIが対応するバックエンドを推奨し、ローカルモデルを読み込んでチャットを始めます。インストーラーはCLIのみを導入するため、ランタイムとモデルは別途インストールが必要で、ビルド済みランタイムはインストール時にSHA-256で検証されます。serveコマンドは127.0.0.1:9000でゲートウェイを起動し、テキストと画像を受け付けるOpenAI互換のチャットAPIと、ツール呼び出しを変換するAnthropic互換のMessages APIを提供します。チャット要求はモデルを読み込んだ後にのみ処理されます。LANモードとCloudflare Quick Tunnel経由の接続にはAPIキーが必要で、管理APIは既定でローカル専用となり、同じ機器からの要求はキーなしで処理されます。内蔵のadvisorが示すメモリ値は推定値で、ランタイムの対応は機器によって異なり、READMEの速度に関する主張は今回の調査では確認できていません。ライセンスはApache-2.0です。 - huggingface/transformers
Transformersは、テキスト、画像、音声、動画、マルチモーダルのモデル定義を集めて推論と学習に使えるようにしたHugging FaceのPythonライブラリです。公開モデルをダウンロードして実行したりファインチューニングしたりしたい研究者、MLエンジニア、開発者が主な利用者で、Hubにはこの形式のチェックポイントが100万以上公開されています。同じモデル定義を、Axolotl、Unsloth、DeepSpeedなどの学習ツール、vLLM、SGLang、TGIなどの推論エンジン、llama.cppとmlxが共通して使う基準の役割を果たします。モデルごとに設定、モデル、前処理器の3つのクラスで構成され、Pipelineはテキスト生成、音声認識、画像分類、視覚的質問応答を数行のコードで実行します。Trainerは混合精度、torch.compile、FlashAttention、分散学習に対応し、generateはストリーミングと複数のデコード方式を提供します。始めるにはPython 3.10以上とPyTorch 2.6以上が必要で、ダウンロードしたモデルはHF_HUB_CACHEフォルダーに保存され、オフラインで使うにはsnapshot_downloadで事前に取得した後にHF_HUB_OFFLINE=1を設定します。serving追加インストールで使うtransformers serveは、localhost:8000にOpenAI SDK互換のサーバーを開き、chat completions、responses、音声の文字起こし、モデル一覧などのエンドポイントを提供します。ツール呼び出しはトークナイザーがツール呼び出し用のトークンを宣言したモデルで動作し、公式文書はこのサーバーを評価と実験、中程度の負荷の配備向けとして紹介し、大規模な運用にはvLLMやSGLangを勧めています。公式READMEはこのライブラリをモデル定義を中心とするツールとして紹介し、学習APIはTransformersが提供するPyTorchモデルに合わせてあるため、一般的な学習loopにはAccelerateを、サンプルスクリプトは状況に合わせて書き換えて使うことを勧めています。READMEにはPyTorch、JAX、TF2.0の間でモデルを移す記述が残っていますが、現在のsetup.py(5.19.0.dev0)とインストール文書はPyTorchだけを扱い、ライブラリはApache-2.0でも各チェックポイントは別のライセンスとアクセス条件を持つことがあります。 - Tencent-Hunyuan/Hy-MT2
Hy-MT2はTencent Hunyuanチームが公開した翻訳専用の言語モデル群で、1.8B、7B、混合エキスパート(MoE)構造の30B-A3Bの3サイズがあります。33言語間の翻訳に対応し、対応言語の表には韓国語と日本語が含まれています。原文と翻訳の指示をプロンプトとして入れると訳文を返し、READMEは用語指定、文体、パーソナライズ、区切り記号、構造化データ向けのプロンプトのひな形を示しています。最大context長は8192トークンで既定のシステムプロンプトがないため、長い文書は分割して入れる必要があります。モデルファイルを小さくしたFP8とGGUFの量子化版は2ビットと1.25ビットの形式まであり、READMEは1.8Bモデルを1.25ビットに量子化すると保存容量が約440MBになると紹介しています。実行には、モデルリポジトリのコードをそのまま実行する設定であるtrust_remote_codeを有効にしたtransformers 5.6.0以降か、ソースからビルドしたvLLM、SGLangが必要で、READMEはllama.cppで低ビット形式を使うにはプルリクエスト22836のSTQカーネルが必要だと案内しています。LLaMA-FactoryとDeepSpeedでLoRAまたはフルファインチューニングができ、学習ガイドは1.8Bに24GB以上のGPU 1枚、7BのLoRAに80GBのGPU 1枚、30Bに80GBのGPU 8枚を求めています。指示に従う翻訳を評価するIFMTBenchもCC-BY-4.0で公開され、6種類の制約をルールとLLMによる採点で評価します。モデルのライセンスはLICENSE.txtによるとApache 2.0で、READMEの性能比較の数値は今回独自に確認できていません。
Trendshiftのランキングに入ったリポジトリだけを載せ、リストは候補を探すためだけに使いました。順位の数字は転載していません。説明、ライセンス、スター数は各GitHubリポジトリで確認しました。解説は私たちの判断です。これらを試験したわけではなく、上昇リストに載ったことは品質の証明ではありません。