Fractal-Compute-Orchestrations/FractalWorkspace
- 출처
- GitHub
- 처음 오른 날
- 분야
- 모델 추론
- GitHub 별 수
- 3,574
- 주 언어
- Python
외부 오픈소스 저장소를 소개하는 글입니다. HDATF 제품이 아닙니다.
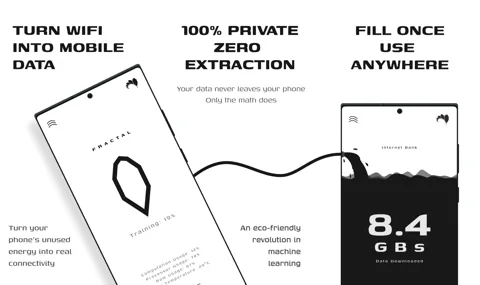
무엇을 하나
FractalWorkspace는 Python 서버와 Android 단말 계산 클라이언트를 묶는 상위 작업 공간과 구조 자료집입니다. README는 학습 작업을 나누고 돌아온 체크포인트를 합치는 흐름과 모델 계층을 여러 단말에 나누어 추론하는 흐름을 설명합니다. 입력은 모델과 데이터 조각, 단말 등록 정보, 자원 예산이며 결과로 통합된 모델 갱신과 추론 출력을 제시합니다. 확인한 서브모듈 설정은 FractalCore와 FractalAndroid를 분리하므로 상위 저장소만 내려받았다고 계산 서비스가 바로 동작하지는 않습니다. 문서상 Python과 Android 빌드 도구, 호환 단말, Firestore를 켠 Firebase 프로젝트, 서버와 클라이언트 설정이 필요합니다. 배터리와 온도 제한, 작업 식별자, 고객별 격리는 시스템 규약으로 설명하지만 이번 조사에서 구성 요소 코드의 종단간 구현을 검증하지는 않았습니다. 개인정보 설명은 모델과 데이터 조각을 내려받는 도식보다 넓게 쓰여 있어 원본 데이터가 절대 이동하지 않는다고 가정하지 말고 실제 경로를 확인해야 합니다. 라이선스는 상용 제한이 있는 소스 공개 형태이며 별도 허락 없는 기업 내부 사용도 제한하므로 자유롭게 도입할 수 있는 오픈소스 프레임워크는 아닙니다.
라이선스
자체 라이선스 표준이 아닌 자체 라이선스입니다. 재사용 전에 라이선스 파일을 직접 읽어야 합니다.
같은 분야 저장소
- deepseek-ai/DeepInfer
DeepSeek 모델의 대규모 추론을 위한 실행 프레임워크이며, 공개판은 완성된 온라인 서비스가 아니라 오프라인 추론용입니다. 모델 운영자가 프롬프트와 모델 체크포인트를 넣으면 생성 토큰과 텍스트를 얻습니다. 공개 지원 모델은 DeepSeek-V4.1-Flash이며, 예제에는 텍스트와 이미지 입력이 있습니다. 최적화 커널, 데이터 및 전문가 병렬 처리, 초안 토큰 검증, 비동기 스케줄링으로 추론 작업을 구성합니다. 정규식과 JSON 스키마 및 문법 기반 출력 제약도 제공합니다. Linux, Python 3.12, GCC 13 이상과 NVIDIA SM100 또는 Huawei Ascend 950이 필요하며, 장치에 따라 CUDA 13 또는 CANN 9.2를 요구합니다. 시작 예제는 Hugging Face에서 가중치를 받거나 로컬 체크포인트를 사용합니다. 완전한 서비스에는 KV 캐시 체계, 단계 분리와 복제본 간 부하 분산을 별도로 갖춰야 하며, 공개 성능 수치를 일반 PC의 결과로 해석하면 안 됩니다. - deepseek-ai/deepseek-recipe
deepseek-recipe는 여러 AI API 형식과 DeepSeek 추론 백엔드 사이를 연결하는 Rust 라이브러리와 Python 바인딩 모음입니다. Messages, Chat Completions와 Responses 요청을 공통 대화 형식으로 바꾸고 모델용 프롬프트 및 토큰 입력으로 변환합니다. 백엔드 출력을 다시 해당 프로토콜의 완성 응답이나 스트리밍 이벤트로 바꾸는 처리도 제공합니다. 도구 정의, 추론 설정과 구조화 출력 정보를 다루지만 실제 모델 추론, 도구 실행과 HTTP 전송은 호출자가 제공해야 합니다. Python은 3.10 이상을 지원하며, 이미지 처리에는 OpenCV 구성과 모델별 지원 여부를 고려해야 합니다. DeepSeek V4는 이미지를 받지 않으며 V4.1용 이미지 입력 경로와 구분됩니다. FastAPI 예제는 실제 모델 대신 고정 답변을 만드는 모의 추론을 사용합니다. 예제에는 인증과 사설망 이미지 주소 차단이 없으므로 설치만으로 공개 운영 서비스를 완성했다고 볼 수 없고, 출력 제약의 실제 강제 여부도 백엔드가 결정합니다. - omnimind-ai/OmniInfer
OmniInfer는 LLM과 VLM(이미지를 함께 읽는 언어 모델)을 로컬에서 실행하는 Rust 기반 CLI이자 로컬 gateway입니다. 실제 추론은 llama.cpp, MLX, MNN, vLLM 같은 기존 runtime이 처리합니다. 배포판은 Linux, macOS, Windows용이며, Android와 iOS 앱은 Gradle 모듈이나 Swift 패키지로 OmniInfer를 넣어 사용할 수 있습니다. omniinfer를 실행하면 터미널 UI가 맞는 backend를 추천하고 로컬 모델을 불러와 대화를 시작합니다. 설치 스크립트는 CLI만 설치하므로 runtime과 모델은 따로 설치해야 하며, 미리 빌드한 runtime은 설치할 때 SHA-256 값으로 검증됩니다. serve 명령은 127.0.0.1:9000에 gateway를 열고, 텍스트와 이미지를 받는 OpenAI 호환 chat API와 tool 호출을 변환하는 Anthropic 호환 Messages API를 제공합니다. chat 요청은 모델을 불러온 뒤에만 처리됩니다. LAN 모드와 Cloudflare Quick Tunnel 접속에는 API key가 필요하고 관리 API는 기본으로 로컬 전용이며, 같은 장비에서 보낸 요청은 key 없이 처리됩니다. 내장 advisor가 내는 메모리 수치는 추정값이고 runtime 지원은 장비마다 다르며, README의 속도 주장은 이번 조사에서 확인하지 못했습니다. 라이선스는 Apache-2.0입니다. - huggingface/transformers
Transformers는 텍스트, 이미지, 음성, 영상, 멀티모달 모델의 정의를 모아 추론과 학습에 쓰게 하는 Hugging Face의 Python 라이브러리입니다. 공개 모델을 내려받아 실행하거나 미세 조정하려는 연구자, ML 엔지니어, 개발자가 주요 사용자이고, Hub에는 이 형식의 체크포인트가 100만 개 넘게 공개되어 있습니다. 같은 모델 정의를 Axolotl, Unsloth, DeepSpeed 같은 학습 도구와 vLLM, SGLang, TGI 같은 추론 엔진, llama.cpp와 mlx가 함께 쓰는 기준 역할을 합니다. 모델마다 설정, 모델, 전처리기 세 가지 클래스로 구성되며, Pipeline은 텍스트 생성, 음성 인식, 이미지 분류, 시각 질의응답을 몇 줄 코드로 실행합니다. Trainer는 혼합 정밀도, torch.compile, FlashAttention, 분산 학습을 지원하고, generate는 스트리밍과 여러 디코딩 방식을 제공합니다. 시작하려면 Python 3.10 이상과 PyTorch 2.6 이상이 필요하고, 내려받은 모델은 HF_HUB_CACHE 폴더에 저장되며, 오프라인으로 쓰려면 snapshot_download로 미리 받은 뒤 HF_HUB_OFFLINE=1을 설정합니다. serving 추가 설치로 쓰는 transformers serve는 localhost:8000에 OpenAI SDK 호환 서버를 열어 chat completions, responses, 음성 전사, 모델 목록 같은 엔드포인트를 제공합니다. 도구 호출은 토크나이저가 도구 호출 토큰을 선언한 모델에서 동작하고, 공식 문서는 이 서버를 평가와 실험, 중간 부하 배포용으로 소개하며 대규모 운영에는 vLLM이나 SGLang을 권합니다. 공식 README는 이 라이브러리를 모델 정의 중심 도구로 소개하며, 학습 API는 Transformers가 제공하는 PyTorch 모델에 맞춰져 있어 일반 학습 loop에는 Accelerate를, 예제 스크립트는 상황에 맞게 고쳐 쓰기를 권합니다. README에는 PyTorch, JAX, TF2.0 사이 모델 이동 문구가 남아 있지만 현재 setup.py(5.19.0.dev0)와 설치 문서는 PyTorch만 다루고, 라이브러리는 Apache-2.0이지만 각 체크포인트는 별도 라이선스와 접근 조건을 가질 수 있습니다. - Tencent-Hunyuan/Hy-MT2
Hy-MT2는 Tencent Hunyuan 팀이 공개한 번역 전용 언어 모델 묶음으로, 1.8B, 7B, 전문가 혼합(MoE) 구조의 30B-A3B 세 크기가 있습니다. 33개 언어 사이의 번역을 지원하며, 지원 언어 표에 한국어와 일본어가 들어 있습니다. 원문과 번역 지시를 prompt로 넣으면 번역문을 내고, README는 용어 지정, 문체, 개인화, 구분 기호 처리, 구조화 자료 번역용 prompt 양식을 제공합니다. 최대 context 길이는 8192 token이고 기본 system prompt가 없어서, 긴 문서는 나눠 넣는 처리가 필요합니다. 모델 파일을 줄인 FP8과 GGUF 양자화 모델은 2비트와 1.25비트 형식까지 있고, README는 1.8B 모델을 1.25비트로 양자화하면 저장 공간이 약 440MB라고 소개합니다. 실행에는 trust_remote_code(모델 저장소의 코드를 그대로 실행하는 설정)를 켠 transformers 5.6.0 이상이나 소스에서 빌드한 vLLM, SGLang이 필요하고, README는 llama.cpp에서 저비트 형식을 쓰려면 pull request 22836의 STQ kernel이 필요하다고 안내합니다. LLaMA-Factory와 DeepSpeed로 LoRA나 전체 미세 조정을 할 수 있으며, 학습 안내 문서는 1.8B에 24GB 이상 GPU 1장, 7B LoRA에 80GB GPU 1장, 30B에 80GB GPU 8장을 요구합니다. 지시를 따르는 번역을 평가하는 IFMTBench 자료도 CC-BY-4.0으로 공개했으며, 6가지 제약 유형을 규칙과 LLM 채점으로 평가합니다. 모델 라이선스는 LICENSE.txt 기준 Apache 2.0이며, README의 성능 비교 수치는 이번에 따로 확인하지 못했습니다.
Trendshift 순위 목록에 오른 저장소만 담았고, 목록은 후보를 찾는 데만 썼습니다. 순위 숫자는 옮기지 않았습니다. 설명과 라이선스, 별 수는 각 GitHub 저장소에서 확인했습니다. 해설은 우리의 판단입니다. 이 프로젝트들을 직접 시험한 것은 아니며, 상승 목록에 올랐다고 품질이 증명되지는 않습니다.