NVIDIA/personaplex
- 出典
- GitHub
- 初登場日
- 分野
- メディア
- GitHubスター数
- 10,546
- 主な言語
- Python
外部のオープンソース リポジトリを紹介するページです。HDATFの製品ではありません。
何をするか
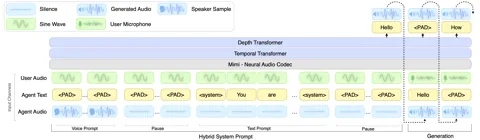
PersonaPlexは、リアルタイムで聞きながら話せるfull-duplexの音声対話モデルです。テキストの役割promptでペルソナを決め、音声サンプルで声を調整します。Moshiのアーキテクチャと重みをベースにしています。
ATFへの役立ち方
私たちの製品とは関係がありません。ランキングに入ったため掲載しています。
ライセンス
MIT 寛容なライセンスです。著作権表示を残せば商用利用と改変ができます。
同じ分野のリポジトリ
- QwenLM/Qwen3-TTS
Alibaba CloudのQwenチームによるオープンソースの音声合成(TTS)モデルシリーズです。ストリーミング音声生成、自由な声のデザイン、声のクローン、自然言語による音声の制御に対応します。 - remotion-dev/remotion
Reactのコードで動画を作るフレームワークで、コードが正本になります。コーディングエージェントで作る、ドラッグ&ドロップで編集する、データにつないで自前のインフラで一括レンダリングする、といった使い方ができます。 - ace-step/ACE-Step-1.5
ACE-Step 1.5は、Mac、AMD、Intel、CUDAデバイスでローカルに動くオープンソースの音楽生成モデルです。数曲からLoRAを学習させ、自分のスタイルを反映できます。 - torvalds/AudioNoise
AudioNoiseは、デジタル音声処理の基礎を学ぶために作られた、phaserやechoなどのシンプルな音声エフェクト集です。IIRフィルターとdelay loopを使い、1サンプルを受けて1サンプルを出す方式で処理します。 - dwzhu-pku/PaperBanana
VLMと画像生成モデルを使って学術論文用の図を作るツールです。Streamlitの画面で使うモデルを選べます。Google ResearchのPaperVizAgentをforkしたプロジェクトです。
Trendshiftのランキングに入ったリポジトリだけを載せ、リストは候補を探すためだけに使いました。順位の数字は転載していません。説明、ライセンス、スター数は各GitHubリポジトリで確認しました。解説は私たちの判断です。これらを試験したわけではなく、上昇リストに載ったことは品質の証明ではありません。