nexu-io/openmotion
- 来源
- GitHub
- 首次上榜日期
- 领域
- 媒体
- GitHub 星标数
- 11,823
- 主要语言
- TypeScript
本页介绍外部开源仓库,并非 HDATF 产品。
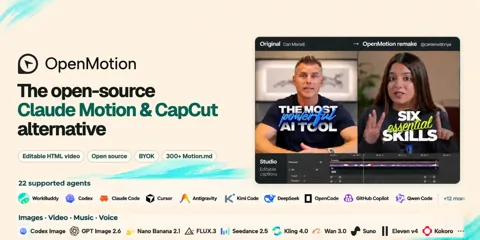
它做什么
OpenMotion是面向视频制作者的本地工作区,用于改编参考视频并保留可编辑源文件。用户提供参考视频或链接、脚本、品牌资料和媒体。外部智能体用HTML、CSS和JavaScript重建场景,并通过Motion.md记录镜头顺序、时间和可替换素材。Studio编辑同一组项目文件,导出MP4并保留可复用源文件和媒体。软件包声明需要Node.js 22.18或更新版本,而当前README建议源码开发使用Node.js 26.11.1。预览和渲染还需要Chrome或Chromium、FFmpeg及FFprobe。可选的媒体生成使用用户自己的供应商账户,因此项目在本地不代表所有生成过程都在设备内完成。导出验证源码检查编码、时长、解码和跳转,但创作品质仍需人工检查,社交平台发布仍属于规划功能。
许可证
Apache-2.0 宽松许可,含专利授权。可商用,需保留声明并注明修改。
同领域的其他仓库
- Vincentwei1021/video-shotcraft
Video-shotcraft是一套面向产品团队的智能体技能和制作工具,用实际产品画面制作可编辑的介绍视频,而不是生成虚构界面的影像。它接收真实截图、已批准文案、视觉风格和音频,指导Claude Code或Codex选择镜头、安排叙事并使用Remotion制作动画,交付源项目和MP4视频。镜头制作指引描述相机运动、转场和时间安排,所检查的示例则用确定性的React组合实现截图布局和动画。示例编辑清单导入原始组合的时间表,分别声明镜头、字幕、转场、音频和可编辑属性结构。Motion Workbench将该清单导入浏览器编辑轨道并通过Remotion输出,但项目需要自行提供清单和公开属性,才能进行有意义的结构化编辑。JianYing导出保留部分字幕和音频轨道,场景内部动画仍烘焙在视频片段中,因此不是将React动画完整转换为原生编辑对象。制作依赖智能体环境、Node.js、Remotion渲染工具、原始截图访问权限及适当的媒体工具,Remotion和音频授权也需要单独核查。逐帧检查和独立智能体复核属于操作指引,不证明系统自动保证质量,预览效果可能不同于最终输出,本次也未实际验证视频质量或编辑器兼容性。 - kajisho5/ffmpeg-skill
ffmpeg-skill让编程代理通过定义好的工具编辑本地视频和音频,而不是自行拼接FFmpeg命令字符串。它接收源媒体、裁剪区间、字幕文件和交付设置,输出编辑后的文件及JSON报告。42个工具覆盖裁剪、拼接、静音删除、画面比例调整、字幕、叠加、音频处理和平台导出。规定的流程先测量源文件,在可行时避免重新编码,完成编辑后再次测量结果。工具输入模式来自脚本实际使用的参数解析器,MCP服务器将工具请求转换为脚本参数。结果检查涵盖时长和响度等可测量属性,联系表图片则供调用方另行检查画面。本地运行需要Python 3.10及以上和FFmpeg 6.1及以上,语音转写还需额外的本地引擎,首次使用可能下载模型权重。工具本身不识别主体或判断精彩片段,技术验证通过也不保证构图、字幕可读性或混音合理。 - hitkeeen/blender-ai-mcp-addon
该项目介绍了Blender中的可视化AI助手和MCP服务器,MCP是供外部AI客户端调用工具的标准接口。文档描述了场景检查、物体创建与编辑、材质设置、素材搜索和场景导出工具。独立的Studio窗口用于展示对话、视口截图、操作审批和任务列表。连接方式包括受支持的云端模型、本地Ollama以及使用指定协议的自定义接口。团队模式将规划、执行和审查分配给不同角色,并按顺序修改场景。一次修正后再次审查失败就会停止流程。内置审批和撤销不构成Python执行的安全沙箱,外部客户端的审批由各客户端自行管理。检查的仓库只有文档和图片,没有实现源码,因此这些功能属于文档声明,而非经过独立验证的运行行为。 - emaspa/openxlr
OpenXLR是一款面向Linux的音频混音器,旨在替代Wave Link。它使用PipeWire的通道和混音,将应用声音与麦克风输入发送到监听输出和虚拟麦克风。后台服务负责设备和音频连接结构,图形界面、终端混音器和OpenDeck插件作为控制客户端运行。麦克风处理和音频插件可以使用独立的软件进程,在受支持的Elgato设备上还可由硬件执行部分处理。PipeWire识别的录音输入都可加入混音器,但硬件控制仅适用于支持的设备。HTTP和WebSocket控制接口使用私有Unix套接字,并检查连接进程的凭据。图形界面与核心控制相互分离,因此关闭界面不会停止音频处理。Wave XLR Pro的硬件混音仍属实验功能,Windows音频插件依赖Wine和yabridge,不能将其理解为提供Windows应用。 - Murea-Labs/InWorld
InWorld将Murea-Mind故事智能体应用与Murea-Fast视听生成服务组合起来,面向希望通过行动延续影像故事、而非只生成孤立文生视频片段的用户。它输入用户行动、世界设定及人物、物体或地点参考图,输出带声音的短视频、后续选项和分支故事记录。智能体规划场景,通过代码定义的确定性检查后请求生成并记录状态变化,再由独立评议模型查看实际生成帧,调整后续选项和部分世界事实。带固定描述的图片维持重复出现对象的身份,世界状态及逐片段记录保存变化条件、参考图顺序、提示词、生成参数和执行轨迹。公开生成器是基于LTX-2.5蒸馏为八步生成的模型,通过仓库内置SGLang提供服务,异步HTTP API接收生成或续接任务并返回状态和可下载MP4,而报告中的Murea-Pro并非已发布模型。开始使用需要Linux CUDA GPU服务、Murea-Fast权重、需接受许可的LTX-2.5基础组件、ffmpeg和ffprobe,智能体还需要Python 3.12及文本和图像模型API凭据。文档生成契约固定24 fps和八步,最多允许481帧且包含续接前缀,单GPU智能体片段限制为已测试的五秒,单张H20生成五秒视频时PyTorch预留GPU内存最高为80,472 MiB,因此并未证明可在普通桌面设备运行。以上数值来自开发方测量而非独立复现,续接音频重新生成、三人物场景不稳定、服务缺乏认证以及独立的模型权重许可条件仍是重要限制。
只收录进入 Trendshift 排行榜的仓库,榜单仅用于寻找候选项目,不转载名次。说明、许可证和星标数来自各 GitHub 仓库。解读是我们自己的判断。我们尚未测试这些项目,上榜并不证明质量。